MiMo-V2.6 工具调用重复问题复盘
Scaling RL 过程中的必经之路,reward 关注正确率的“奖励盲区”
MiMo-V2.6 上线后,在 MiMo Desktop、MiMo Code、OpenCode 等使用场景中,模型有时会反复发起相同或高度相似的工具调用,消耗大量时间和上下文,却迟迟无法推进任务。我们内部测试的统计发现,Response 级别的复读率超过 0.05%。工具调用复读成为影响用户体验最突出的问题之一。
不同 Harness 下,MiMo-V2.6-Pro 与 Flash RL 后的模型的工具复读率
| Harness | MiMo-V2.6-Flash-RL | MiMo-V2.6-Pro-RL |
|---|---|---|
| OpenCode | 1.02% | 0.54% |
| MiMo Desktop | 0.19% | 0.19% |
| Claude Code | 0.27% | 0.10% |
| OpenClaw | 0.17% | 0.08% |
| Codex | 0.23% | 0.07% |
| MiMo Code | 0.11% | 0.07% |
| DeepSeek Harness | 0.17% | 0.07% |
| Hermes | 0.16% | 0.05% |
| Zcode | 0.07% | 0.05% |
工具调用复读现象分析
在分析这一问题之前,需要区分正常的并行工具调用、工具调用洪泛(tool-call flooding),以及工具调用复读。
并行工具调用是模型提高执行效率的一种正常方式。例如,模型可以同时读取多个相关文件,或执行彼此独立的查询。这些调用即使使用同一种工具,只要服务于不同的信息需求,也不应被视为复读。当模型集中发起的调用数量明显超出任务需要,或超过执行环境能够有效处理的范围时,则会形成工具调用洪泛(tool-call flooding),带来执行排队、反馈堆积等问题。
工具调用复读则指缺乏合理必要性的重复行为。在可用信息和环境状态没有实质变化、也不存在合理重试或复核需求的情况下,模型仍不断生成语义相同或高度相似的调用,无法带来有效的任务进展。这既可能表现为单次 response 内重复生成多条相同调用,也可能表现为收到工具反馈后,仍在后续轮次中重复同一操作,或循环执行同一组操作。失败后的合理重试、必要的状态轮询,以及修改代码后的再次测试,不属于这里讨论的复读。
调用洪泛与复读可以独立出现,也可能相互叠加:模型在每轮输出中生成大量重复调用,又在后续交互中持续重复这一行为,使冗余执行和上下文消耗进一步累积。用户看到的是工具不断运行,但任务没有相应进展,最终表现为等待时间变长、交互卡顿,甚至任务无法完成。
上述复读是行为层面的定义。由于“语义相同或高度相似”难以稳定地自动判定,本文采用一个更窄但可复现的统计口径:单轮内精确重复。以同一个 assistant 轮次中、模型尚未收到任何工具反馈的一批调用为单位,若两个调用的工具名相同,且参数经 JSON 规范化后完全一致,则将其视为重复。设该轮调用总数为 N,去重后的调用数为 U,则单轮内精确重复率为:
(N − U) / N
这一口径有两个优点:其一,同一轮内的调用之间没有工具反馈,因此通常不能以“基于结果的合理重试”解释;其二,判定可由单轮输出直接回放和复现。但该指标衡量的是可观测复读的下界,而不是完整复读率,更不是洪泛程度。有三类明显的复读没被算进去:(a)跨轮次的重复:拿到反馈之后,在后面的轮次里重发同一个操作,或者循环跑同一组操作;(b)参数改了一点、但信息需求实质没变的近似重复;(c)code-mode harness 下的调用:模型对外只发 exec 这一种工具,真正的工具调用全在 exec 携带的脚本里。统计只看到 exec 这一层,一段脚本里调了同一个工具几次、参数是否相同,都不在统计之中。
为定位这一问题,我们将内部测试数据已出现复读的样本回放至不同 RL 训练阶段的模型(step = 0、5、10、15、20),在同一批问题样本上比较复读行为的复现情况,分析其随训练推进的变化。
可看到如下表,在 MiMo-V2.6-Flash 模型 RL 训练早期,在已经产生复读数据里,回放后仍然存在洪泛行为的(大于 10 次工具调用)的频率就较高(11.1%),随着 RL 训练进行到 20 step,洪泛率攀升到 24.6%。从不同 harness 层面来看,MiMo Code 一开始洪泛的比例就较高(30.6%),RL 训练后期放大到 41.7%。
| RL 训练步数 | 不同 Harness 并行工具调用 ≥10 的比例 | |||||
|---|---|---|---|---|---|---|
| MiMo Desktop | MiMo Code | OpenCode | Codex | Claude Code | 所有 Harness | |
| 0 | 11.1% | 30.6% | 5.6% | 5.6% | 8.3% | 11.1% |
| 5 | 16.7% | 22.2% | 0% | 5.6% | 8.3% | 8.7% |
| 10 | 25.0% | 44.4% | 0% | 11.1% | 5.6% | 16.7% |
| 15 | 33.3% | 38.9% | 25.0% | 8.3% | 2.8% | 22.5% |
| 20 | 33.3% | 41.7% | 27.8% | 16.7% | 5.6% | 24.6% |
奇怪的是,我们在 RL 过程中其实已经针对工具调用洪泛(tool-call flooding)设置了 penalty。具体规则是:在 rollout 过程中,如果某一轮的工具调用超过 32 次,则对该条 rollout 执行 early stop,并将其 reward 直接置为 0。在后续梯度优化时,会 mask 掉前序轮次,仅对触发该规则的当前轮次进行惩罚;惩罚范围覆盖该轮次的全部 token,包括 CoT token。
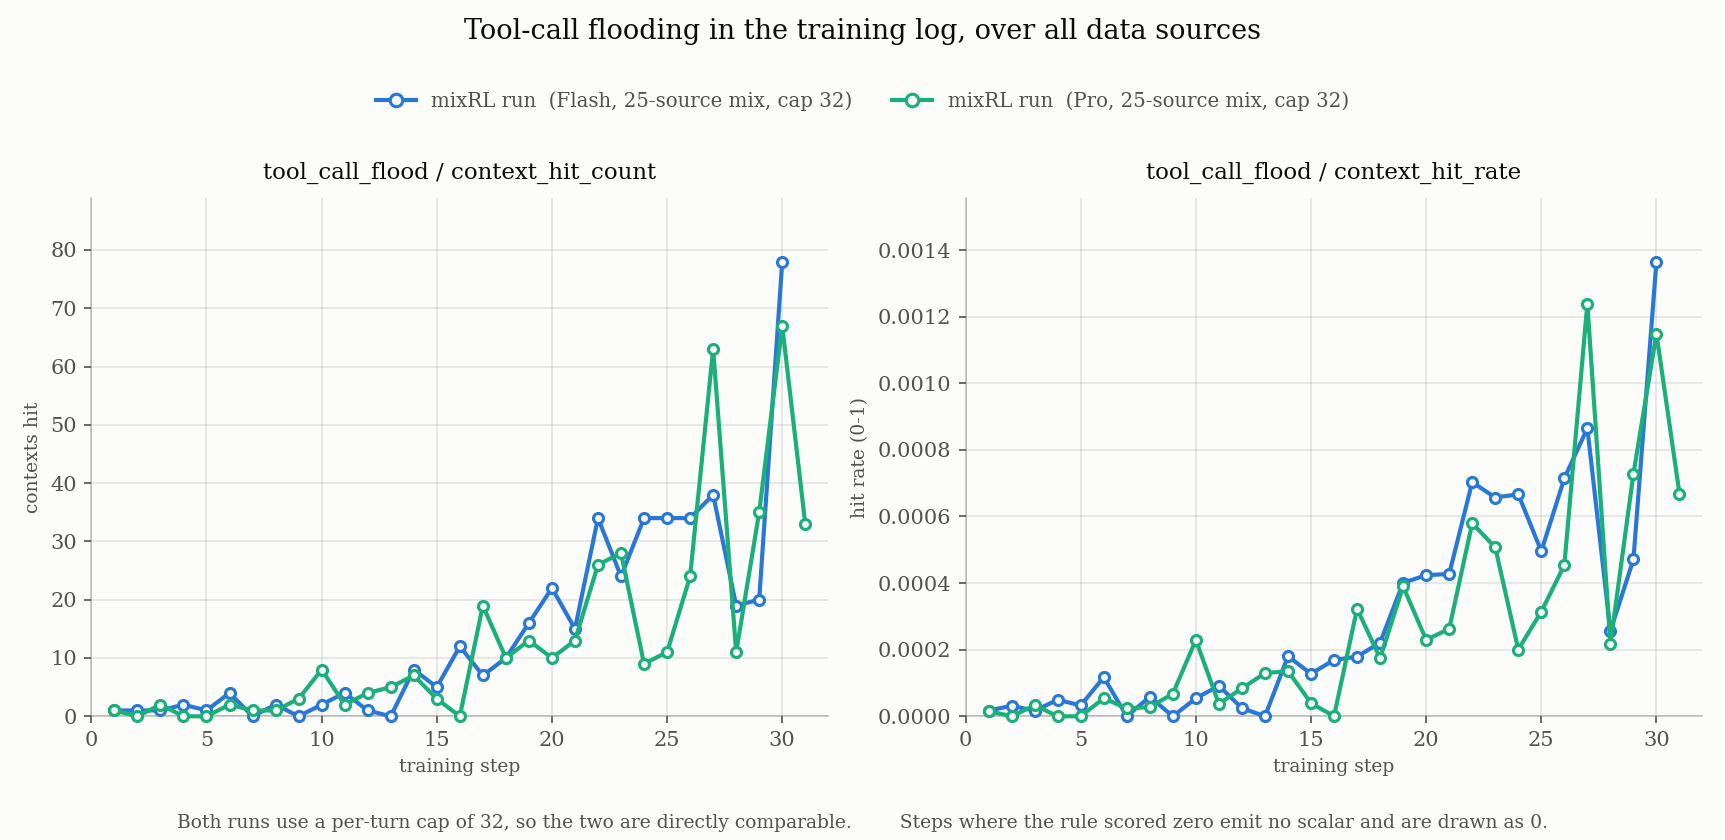
我们回溯了 RL 训练过程中的相关 metrics,发现模型在训练早期几乎不会触发 tool-call flooding penalty;但大约从 step 15 开始,单轮工具调用超过 32 次的样本数量开始明显上升,并且随着训练推进整体呈持续爬升趋势。
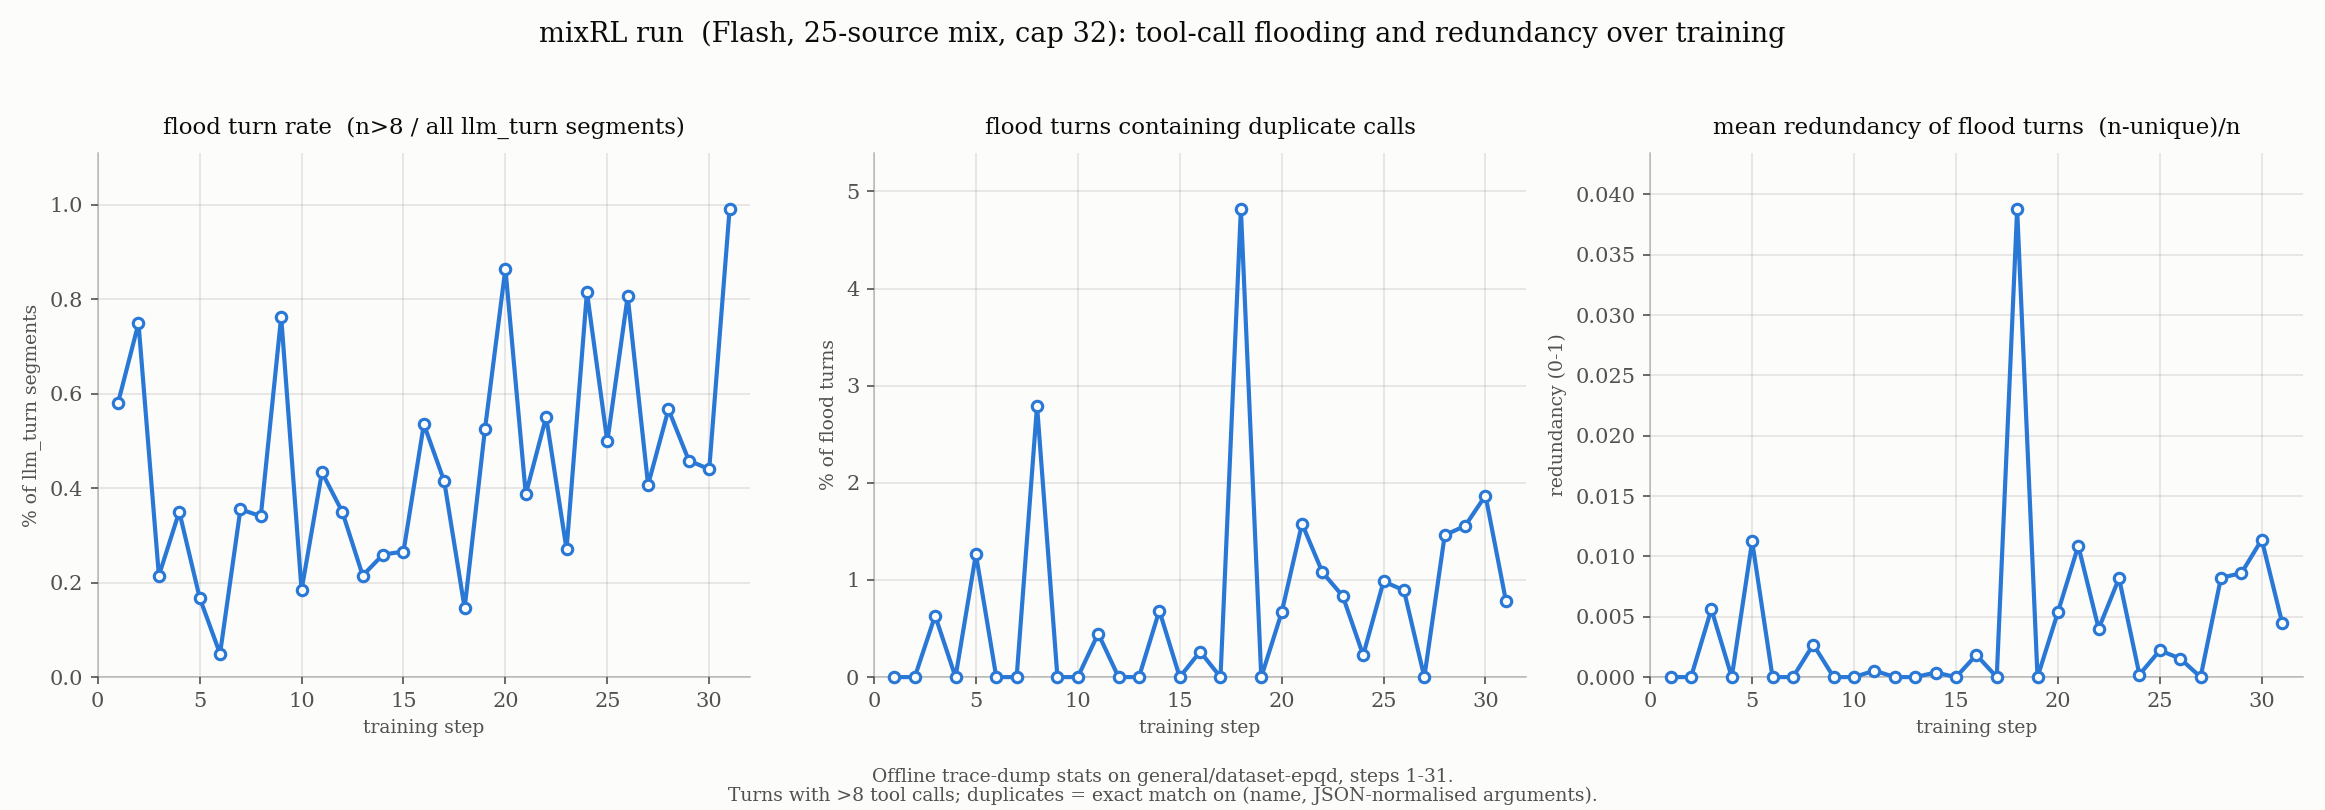
进一步分析后,我们推测问题可能来自 tool-call flooding penalty 的触发阈值过松。下图基于 MiMo-V2.6-Flash 的训练 trace 中的 general/dataset-epqd 数据源,统计了单轮工具调用超过 8 次的样本占比。可以看到,即使在 RL step = 0 时,模型已经存在少量高并发工具调用的行为;由于这类尚未达到 32 次阈值的 flooding 行为不会受到惩罚,随着 RL 训练推进其发生比例逐渐上升,并最终发展为单轮超过 32 次的严重 flooding。需要说明的是,部分 flooding trace 可能伴随重复或高度相似的工具调用,但这里关注的是调用次数异常增长本身,并不将 flooding 等同于 repetition。
昂贵但泛化有限的解决方法
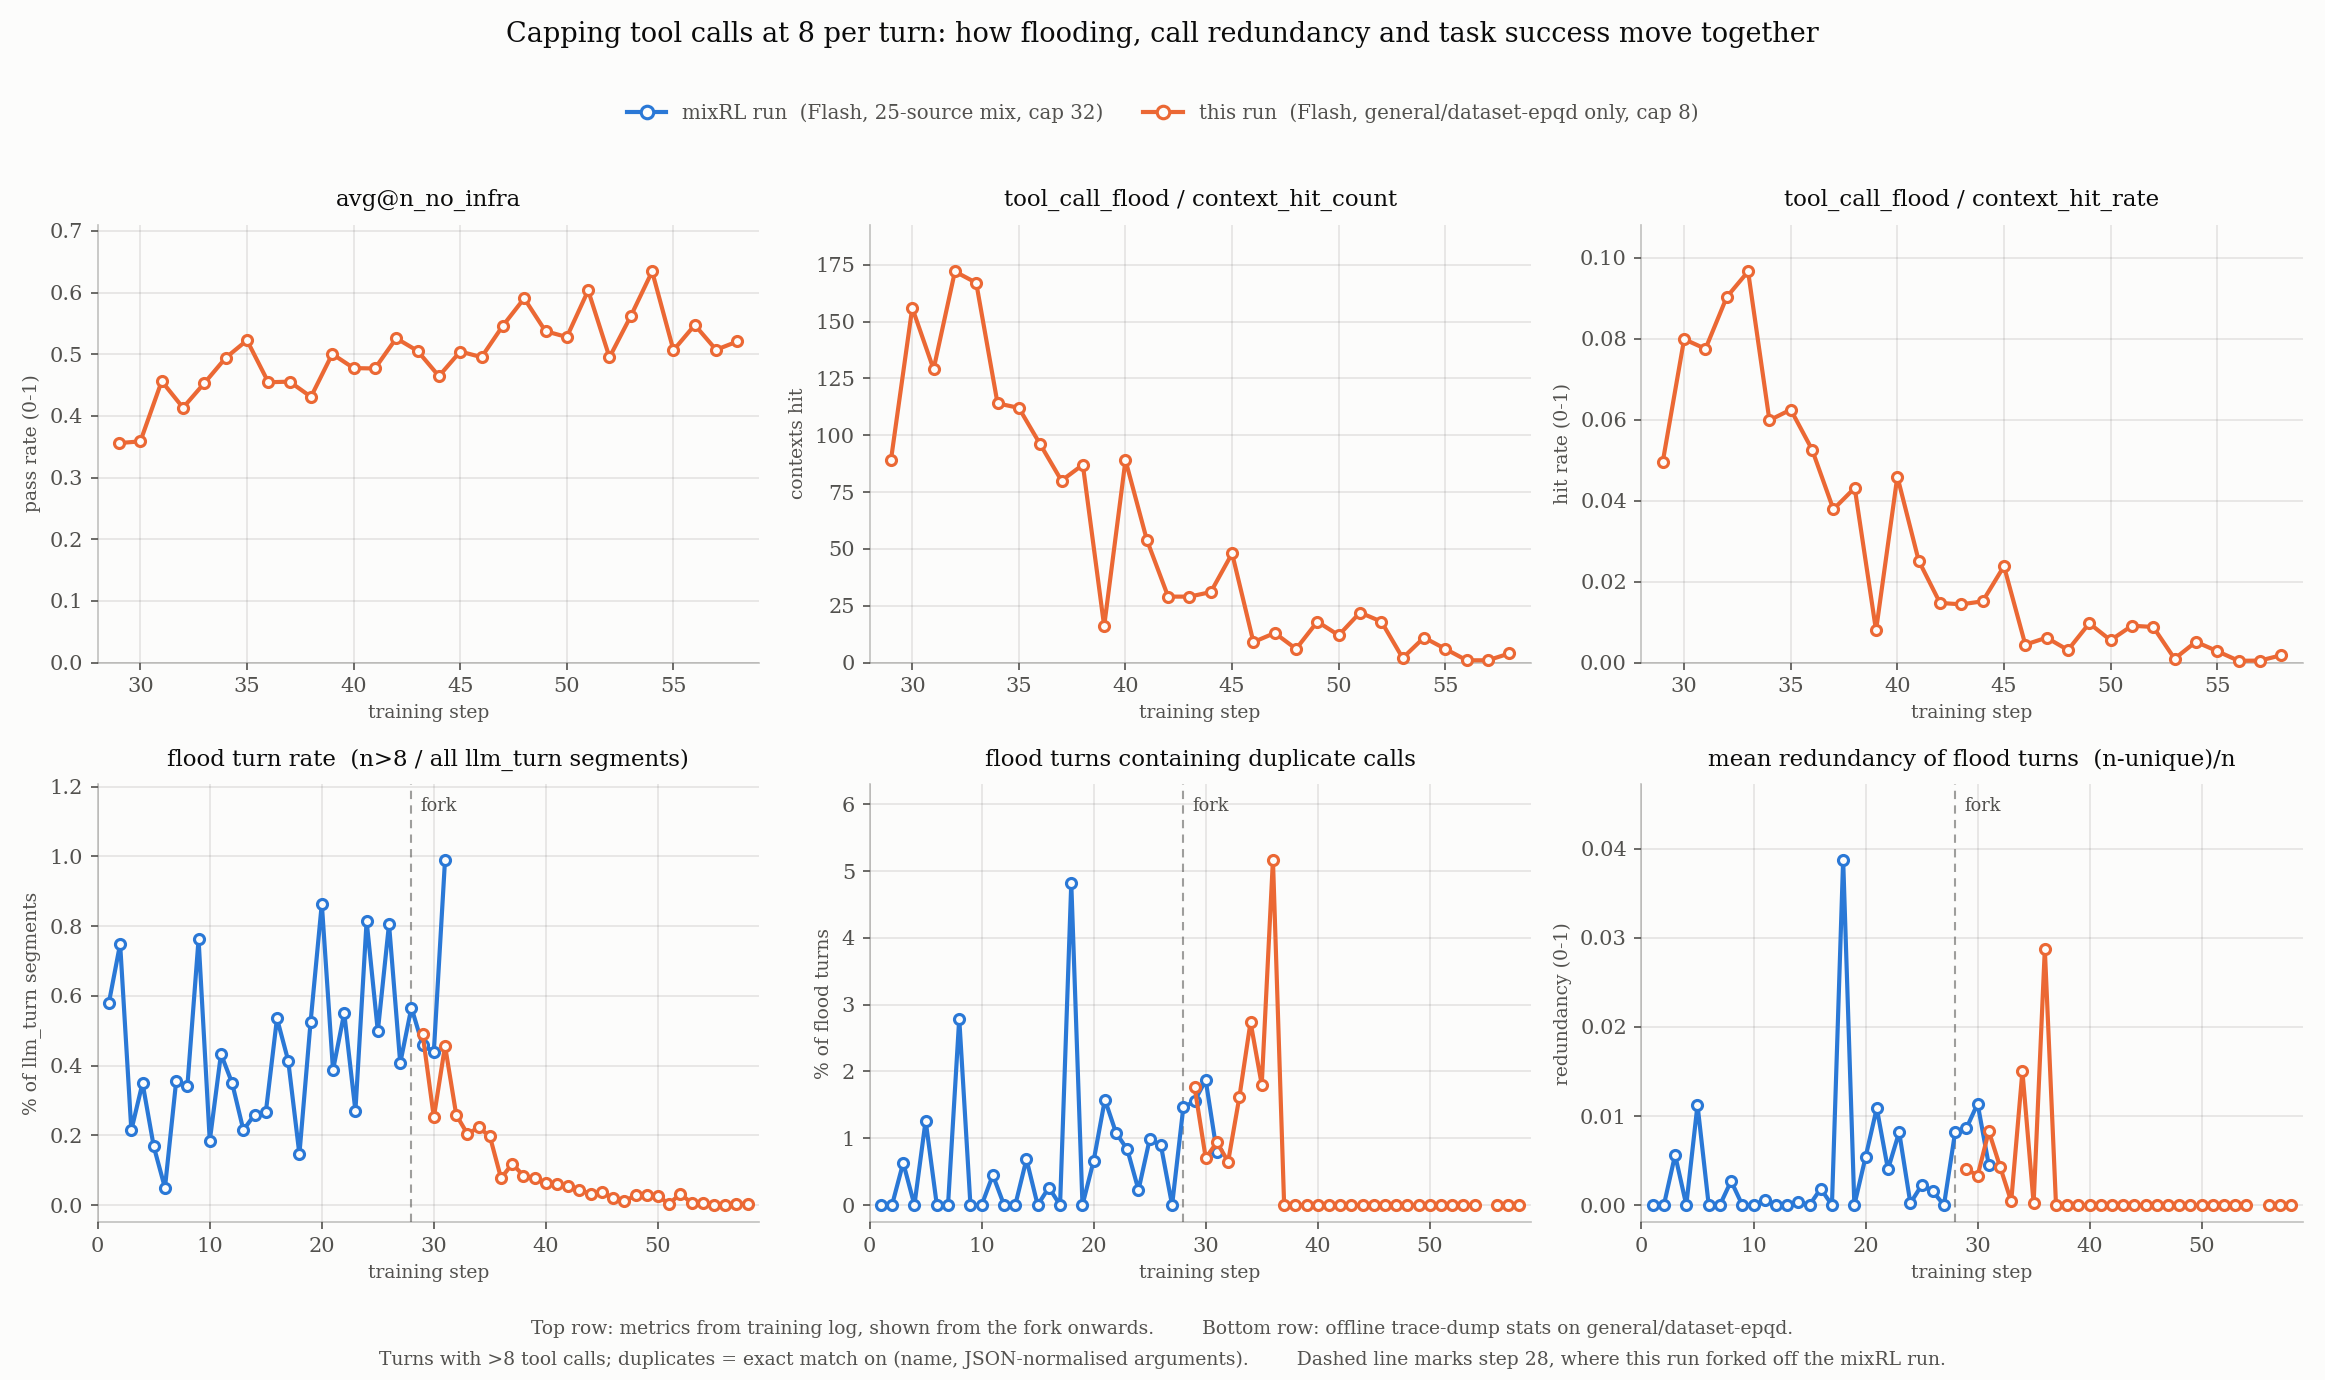
一个最直接的解决方案,是在 RL 训练中进一步收紧 tool-call flooding penalty 的触发阈值。我们将原先单轮工具调用超过 32 次才触发 penalty 的规则调整为超过 8 次即触发,并在一个独立的 general/dataset-epqd 小数据源上从 MiMo-V2.6-Flash 的 step 28 checkpoint 开始 resume 训练。随着实验进行,单轮工具调用超过 8 次的轮数明显下降,说明这一策略能够有效抑制工具调用洪泛;与此同时,更严格的 flooding penalty 并未带来明显的整体 reward 损失。这一方案的主要问题在于,penalty 的效果需要经过一定训练步数后才逐渐生效(约 20 steps)。这意味着我们需要重启 20 步 MixRL 训练,这个代价是巨大的(约 231 万美金)。
此外,仅依靠 RL 训练中的 tool-call flooding penalty,似乎其泛化到内部全量测试数据的效果也较为有限。同样,我们使用 RL 后的 checkpoint 回放内部测试复读数据,虽然复读率从 13.45% 降低到 3.83%,但复读现象仍然存在。
收紧阈值后各 checkpoint 的回放复读率。历史 N 指回放请求的可见历史中已有 N 轮出现 ≥10 次工具调用
| Checkpoint | 内部测试集1 · 历史 0 | 内部测试集1 · 历史 1 | 内部测试集2 · 历史 0 | 内部测试集2 · 历史 1 |
|---|---|---|---|---|
| flash-ga-grpo-s30 | 2.27% (1/44) | 28.57% (4/14) | 13.45% (30/223) | 25.00% (13/52) |
| flash-ga-grpo-s35 | 9.30% (4/43) | 33.33% (5/15) | 7.86% (18/229) | 17.65% (9/51) |
| flash-ga-grpo-s40 | 11.11% (5/45) | 33.33% (5/15) | 4.58% (11/240) | 17.86% (10/56) |
| flash-ga-grpo-s45 | 0% (0/45) | 28.57% (4/14) | 4.40% (11/250) | 11.67% (7/60) |
| flash-ga-grpo-s50 | 0% (0/43) | 28.57% (4/14) | 3.83% (9/235) | 16.98% (9/53) |
高效且泛化极好的解决方案
为了兼顾训练效率,以及样本外真实场景的泛化效果,我们最终选择 MOPD(Multi-teacher On-Policy Distillation)的方式来更优雅地解决这个问题。
方法很简单,我们首先基于内部测试的复读数据,训练了一个单轮的特化 RL teacher:reward = 0 即为发生复读,reward = 1 即为没有复读且没有错误工具调用行为,并通过 KL Loss 限制其与原来的 RL 模型参数不要距离太远。该特化 RL teacher 仅在 12 步训练后(约 7000 条训练样本),就把样本内外的复读数据回放的复读率降低为 0。
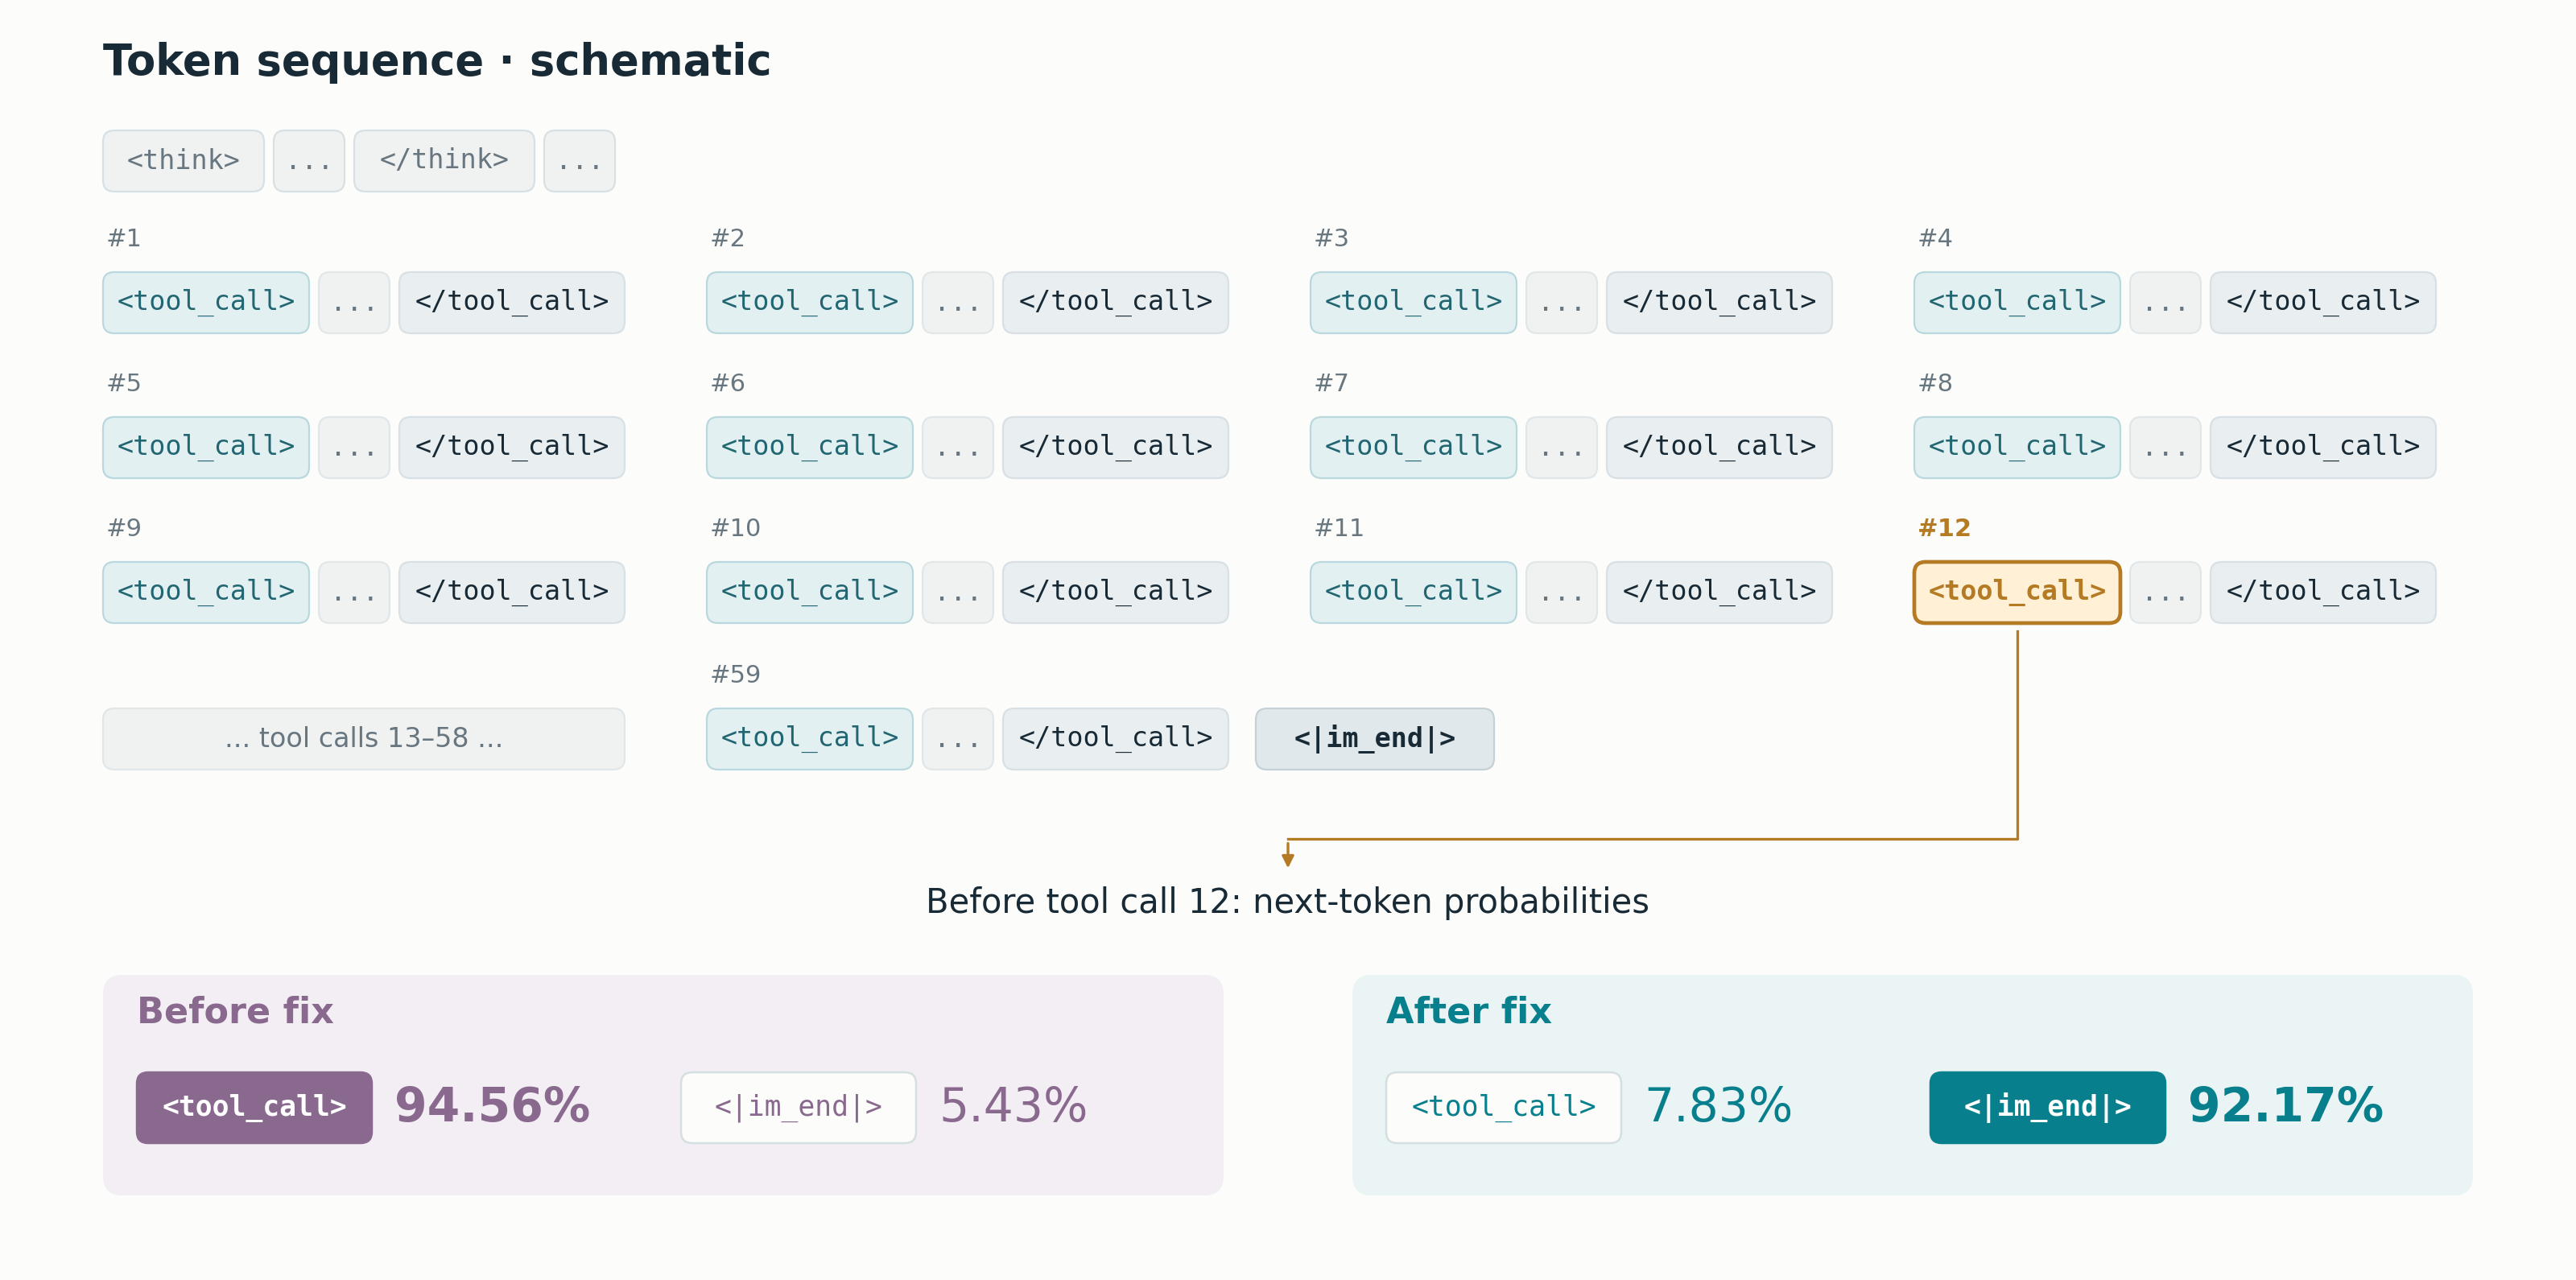
我们从 RL 的轨迹中抽取了一个样例做具体分析,以从微观角度展示工具调用过多的起因和 RL 修复效果。在该样例中,修复前的模型执行了 59 次工具调用。我们从这个样例中取出所有的 <tool_call> token 位置,对每个位置,计算其修复前和修复后的模型预测为 <|im_end|>(结束符)的概率并绘图展示。
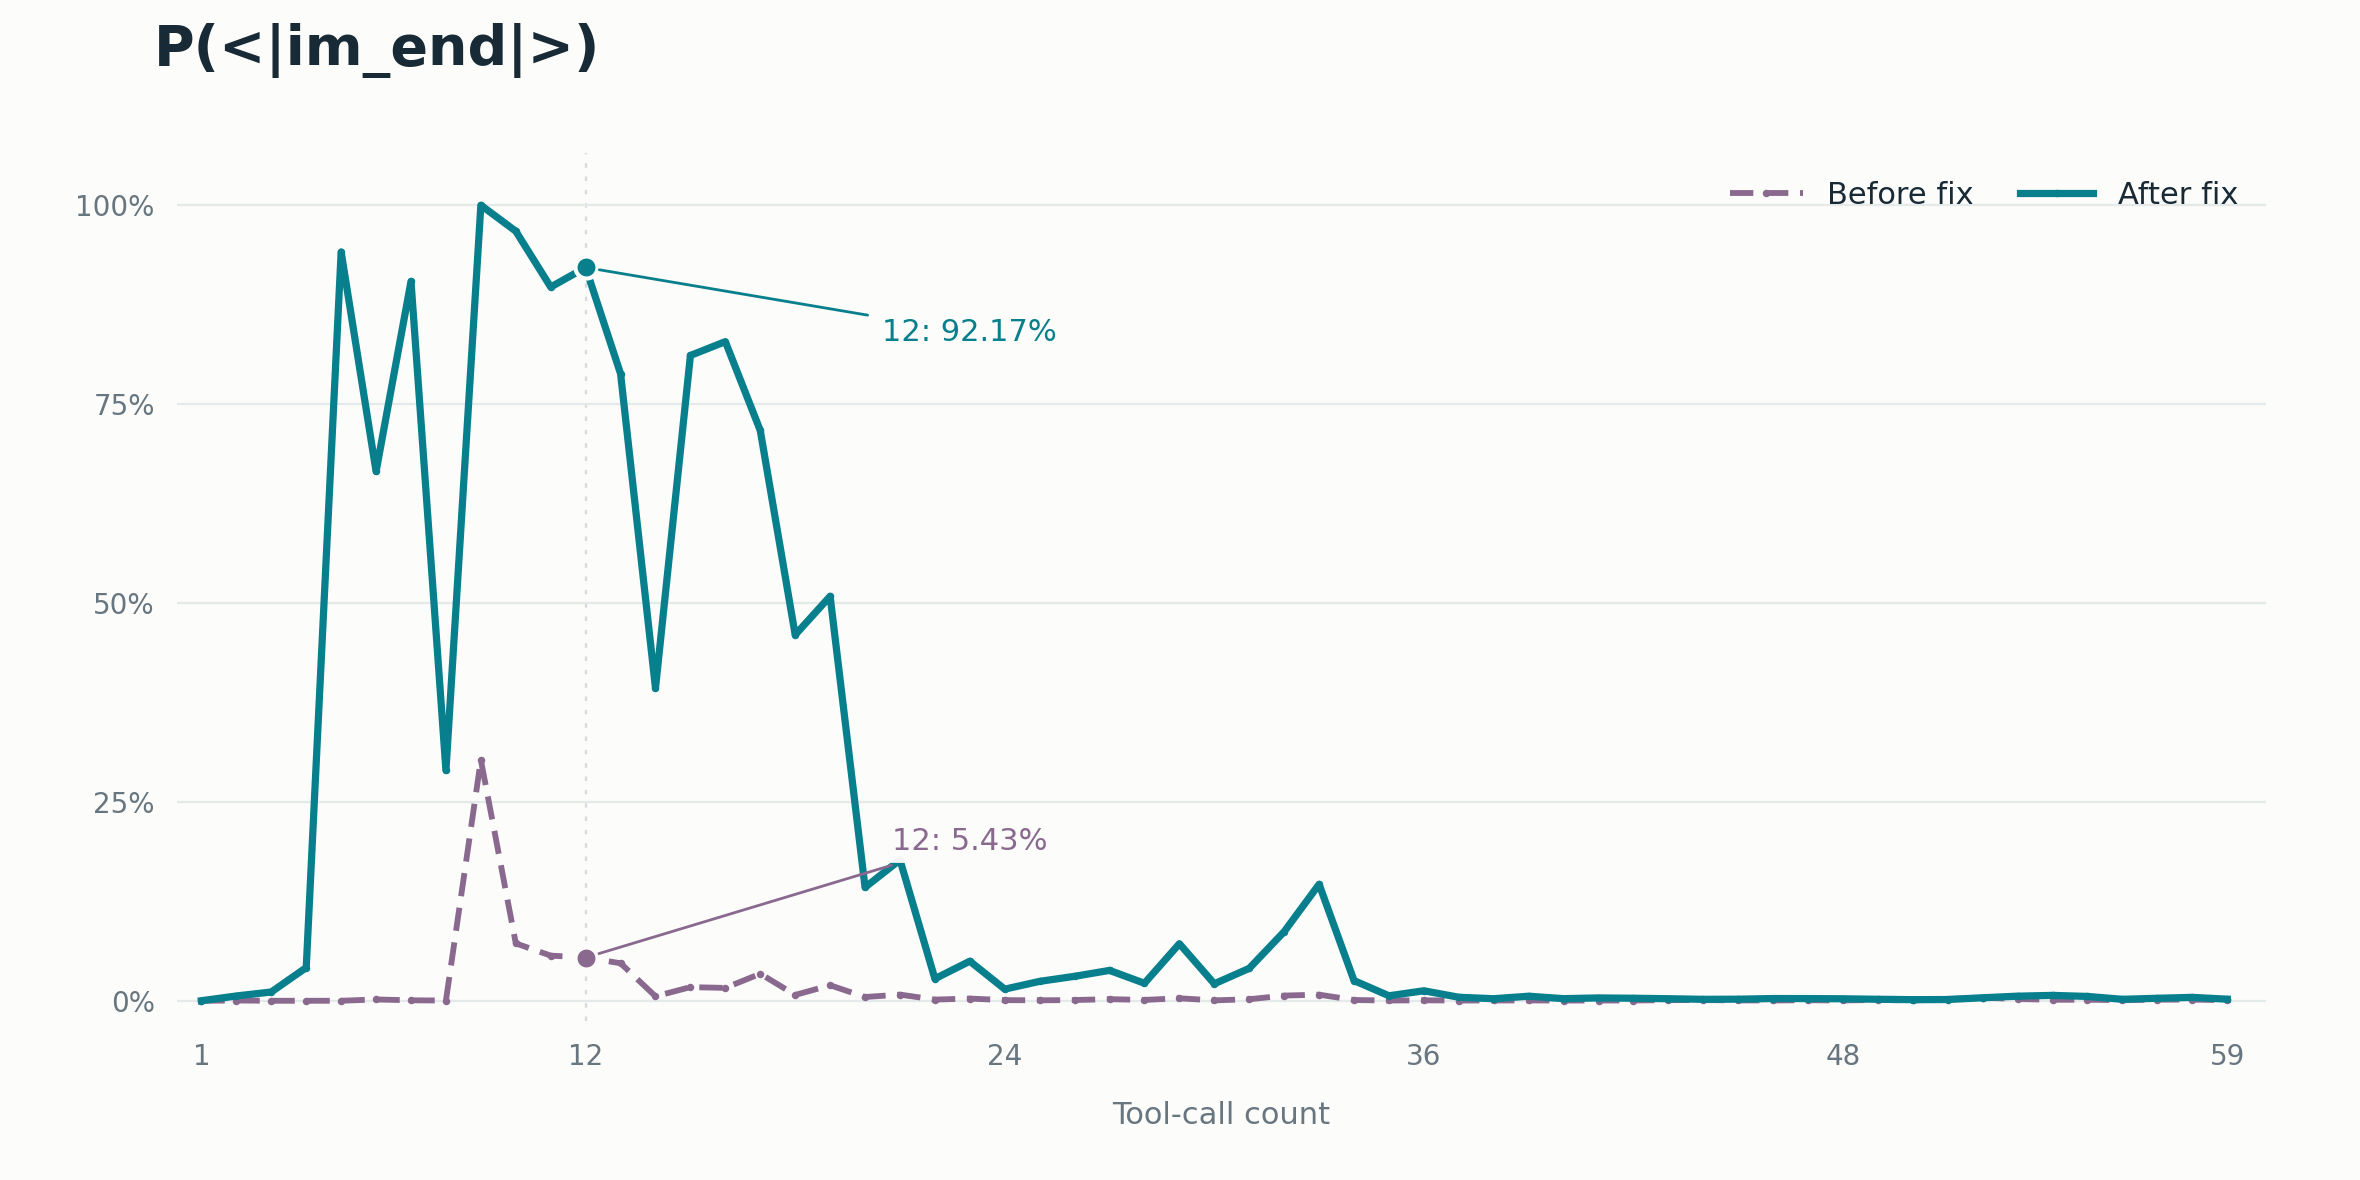
我们另外计算 k 位置的累计结束概率:
Fk = 1 − ∏i=1k (1 − pi)
其含义为模型在本轮调用低于 k 个工具的概率,绘图展示如下:
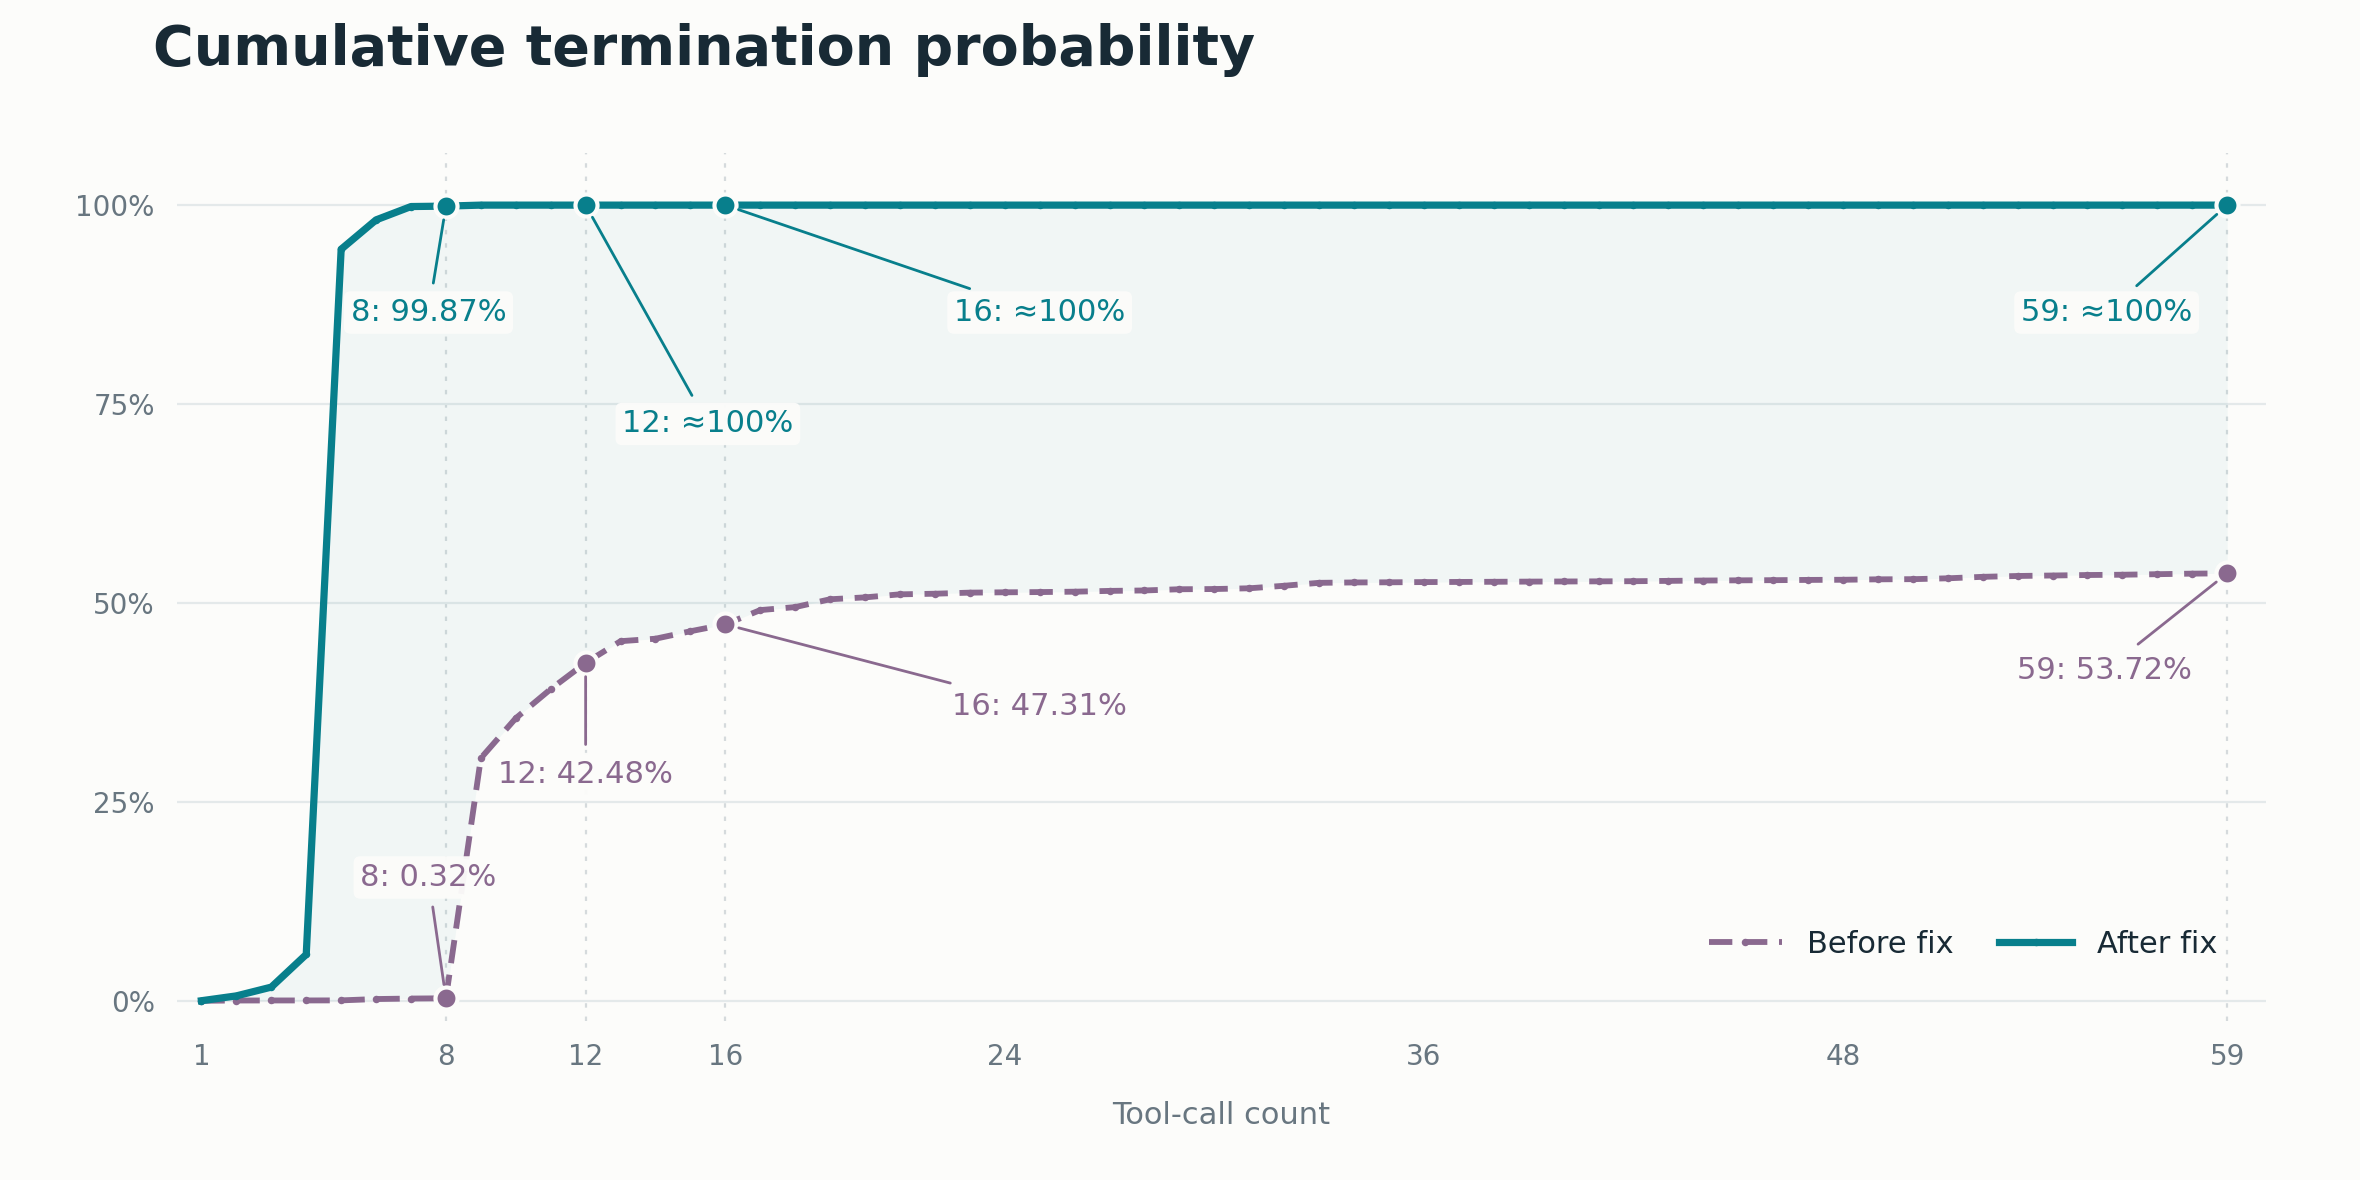
可以看出,在该测试样例中,修复后的模型高概率(99.87%)倾向于在 8 次工具调用以内结束本轮,并且在第 5 到第 20 次调用位置上每一步都有强烈的结束意愿;而修复前的模型累积到第 59 次调用时,仍然只有约一半的概率停止。
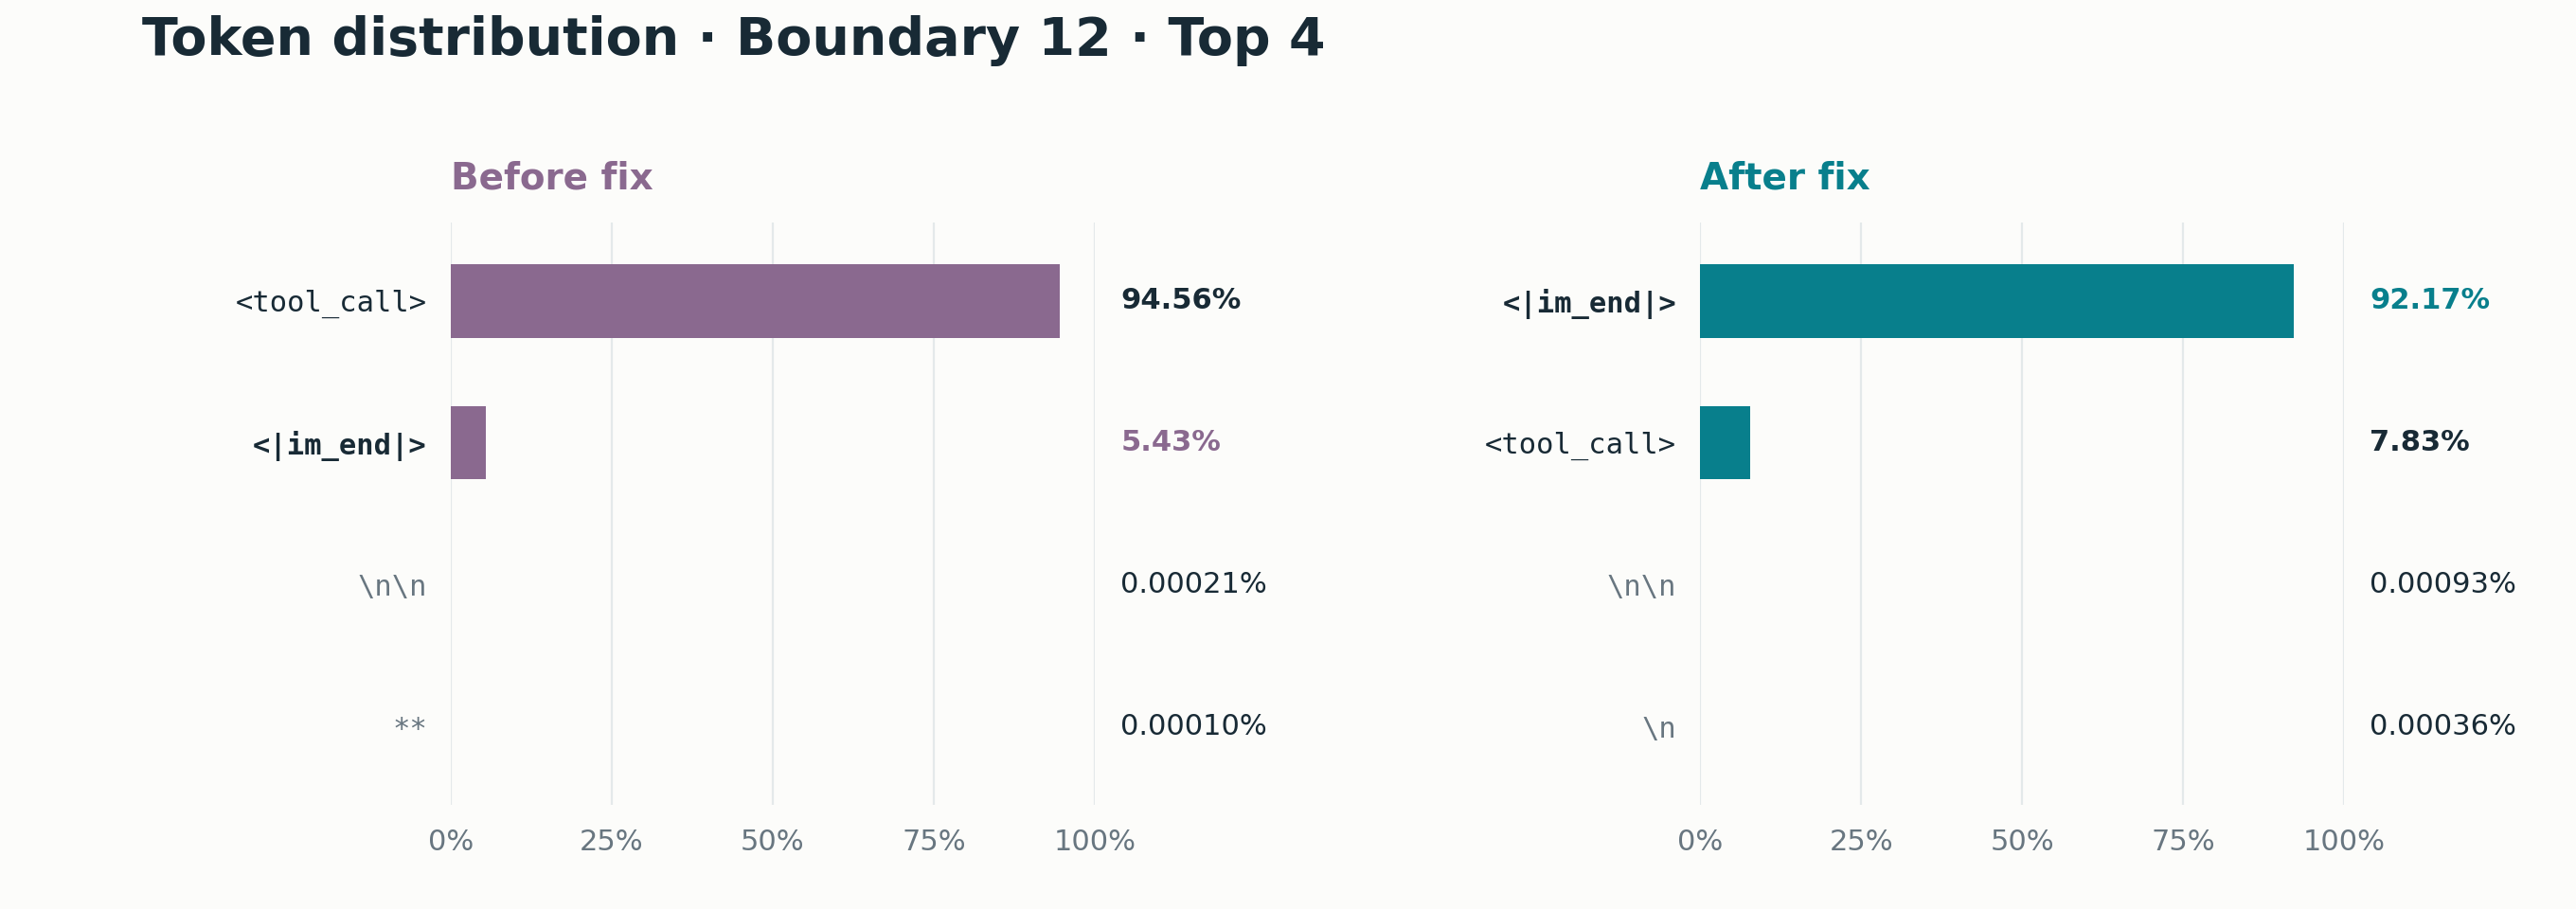
下图展示了第 12 次工具调用位置的 top-4 概率分布:修复前的模型有 94.56% 的概率在此位置继续做工具调用,而修复之后模型以 92.17% 的概率在此位置结束。这说明经过 RL 训练,该 RL teacher 学会了如何在合适的地方停止工具调用。接下来我们考虑如何通过 MOPD 将这个特化 teacher 合并到主模型中。
具体来说,我们将 final run 的 MOPD 训练回退了 5 步,引入复读特化的 RL teacher(采取 teacher prefix 方式的 OPD,详情见技术报告 Section 5.6),继续训练。训练过程中,工具调用的 flood_opd_loss 一直在降低,而整体 opd_loss 保持稳定。
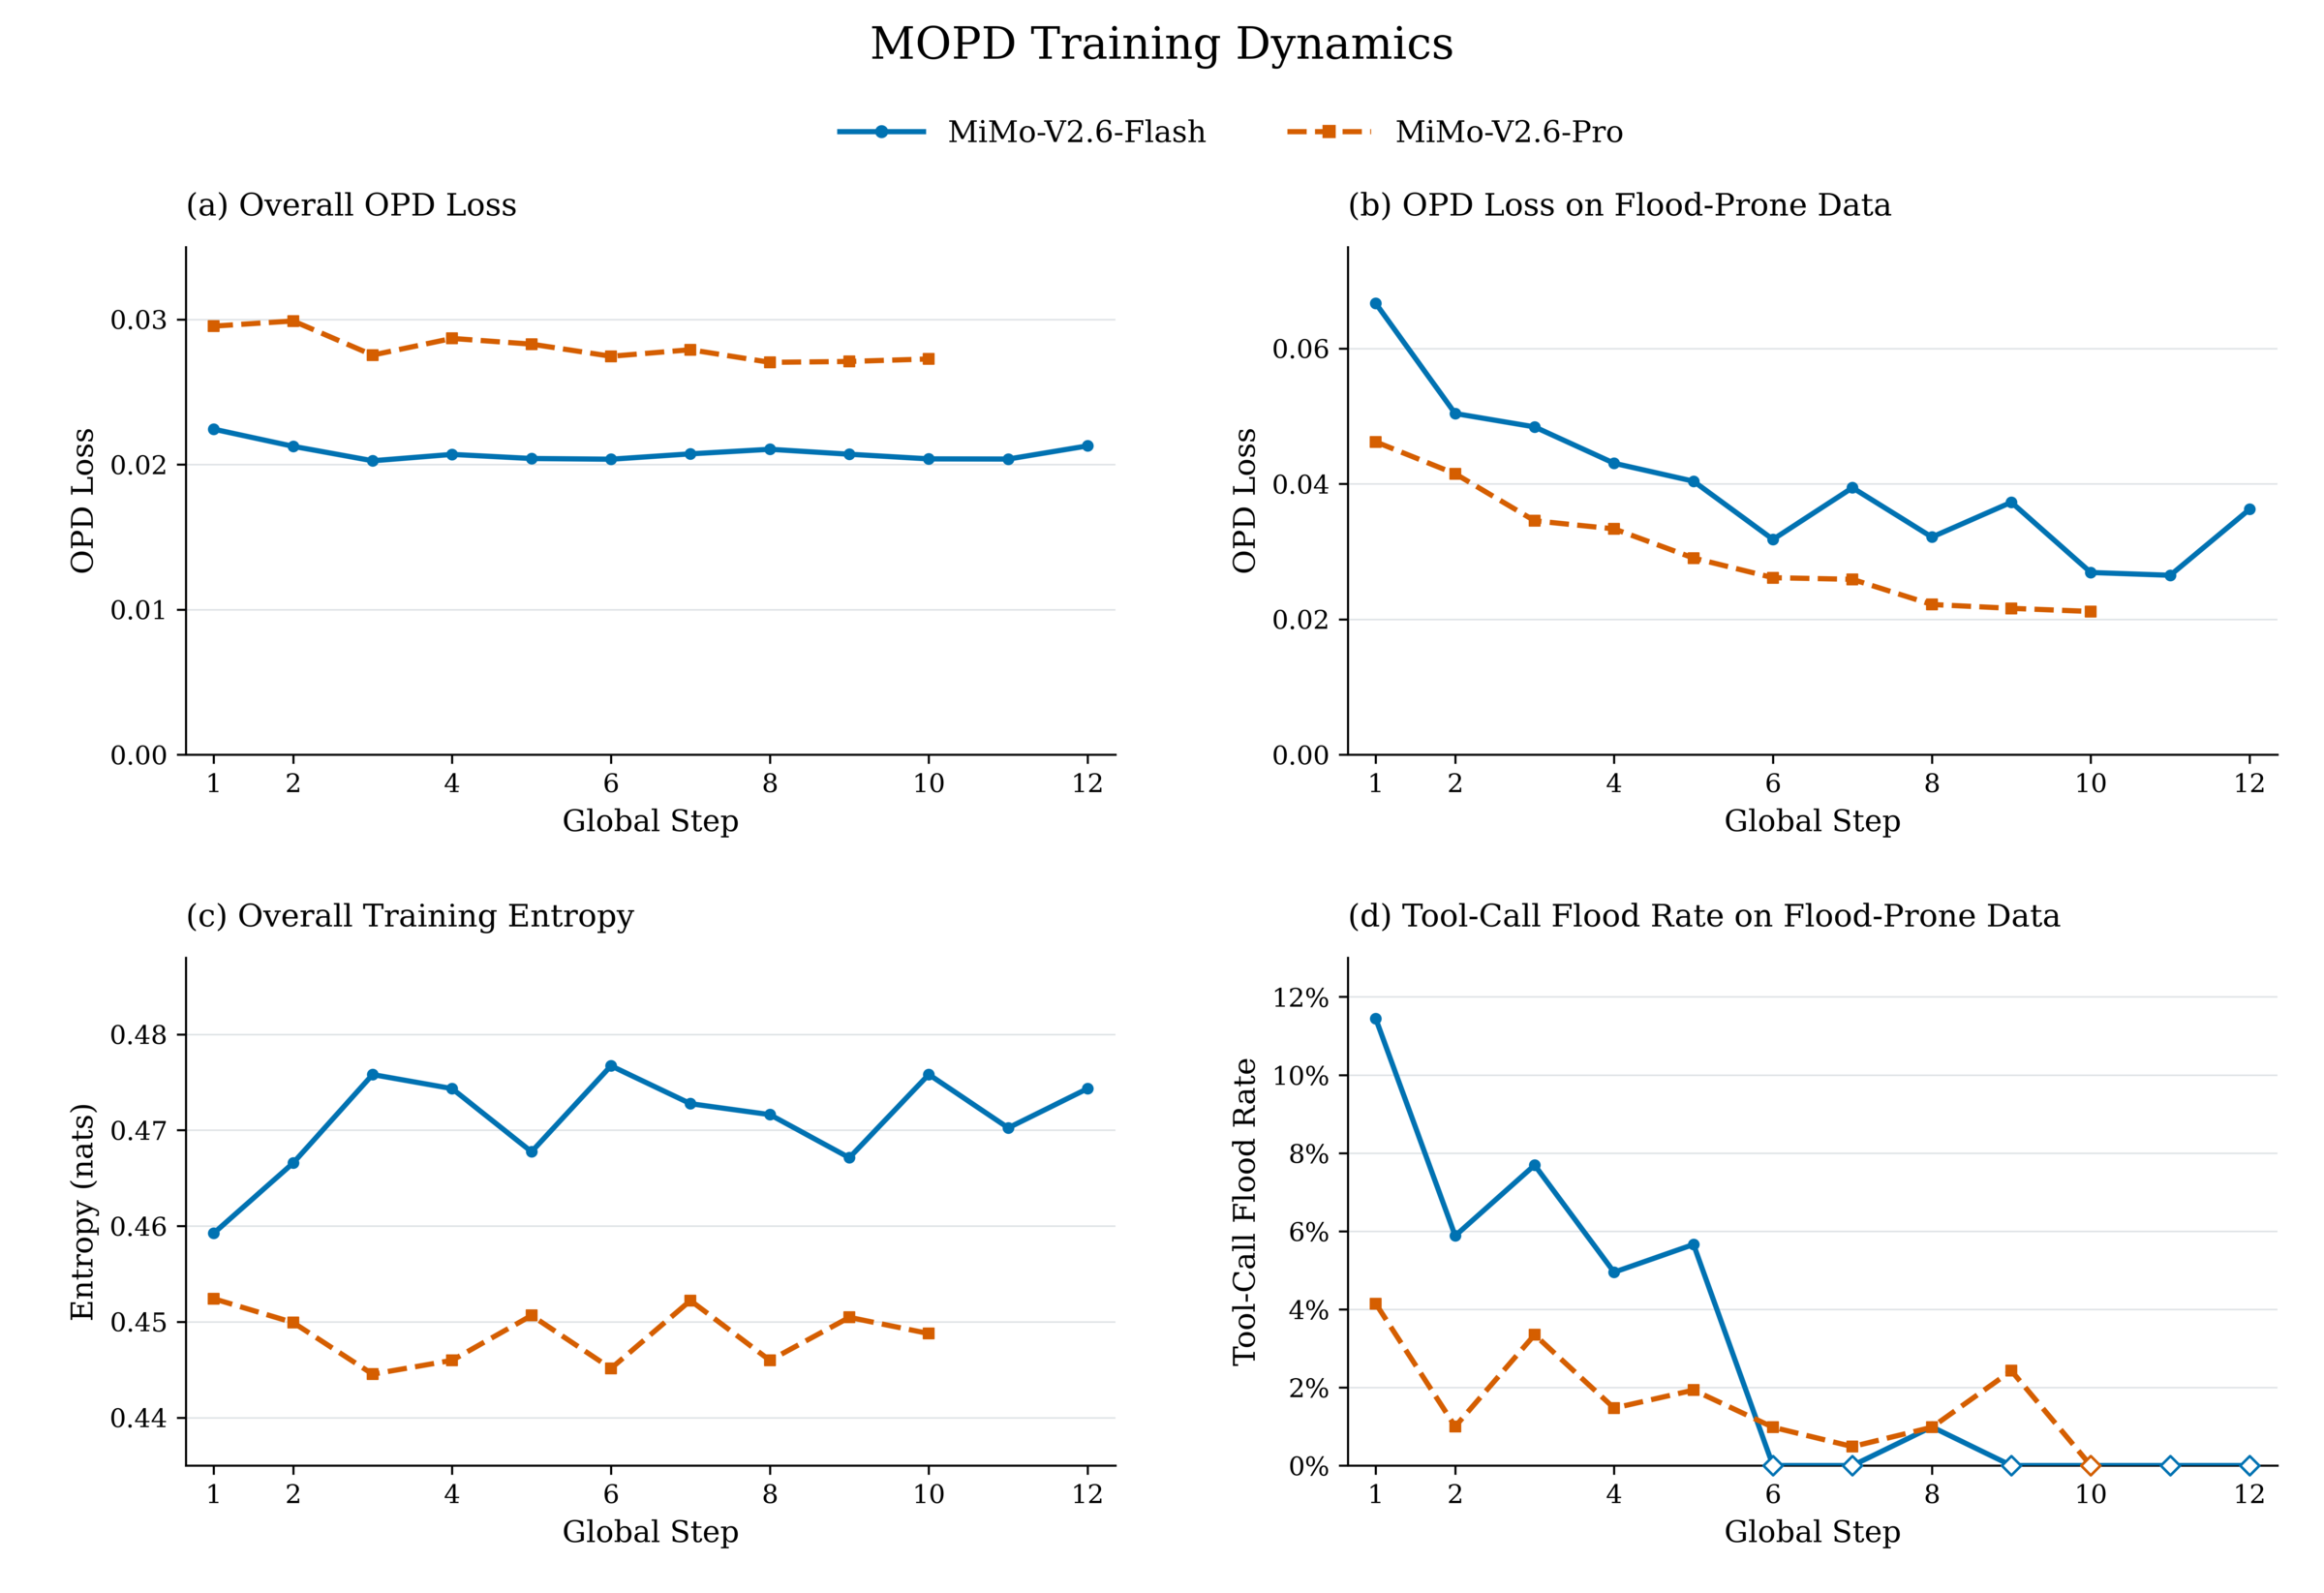
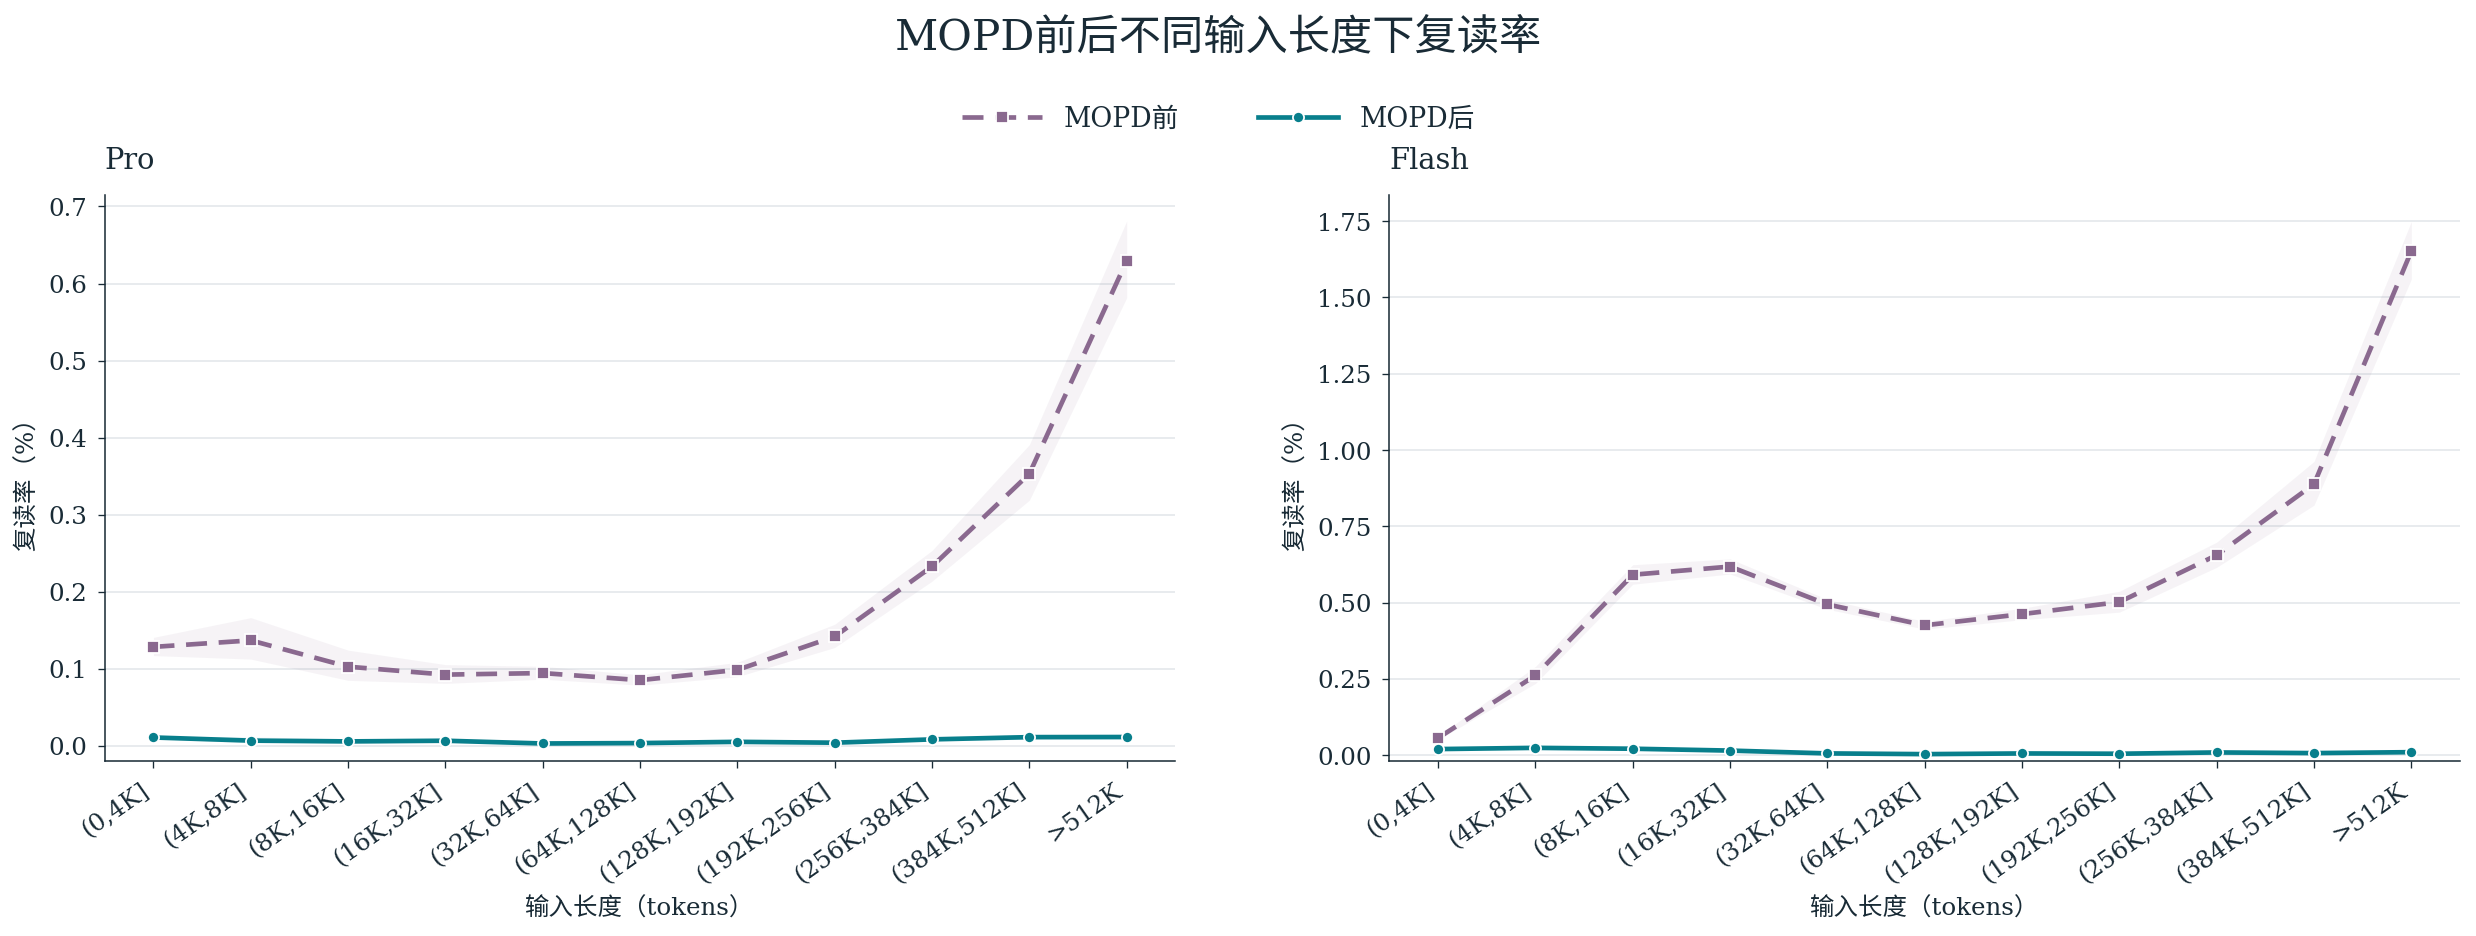
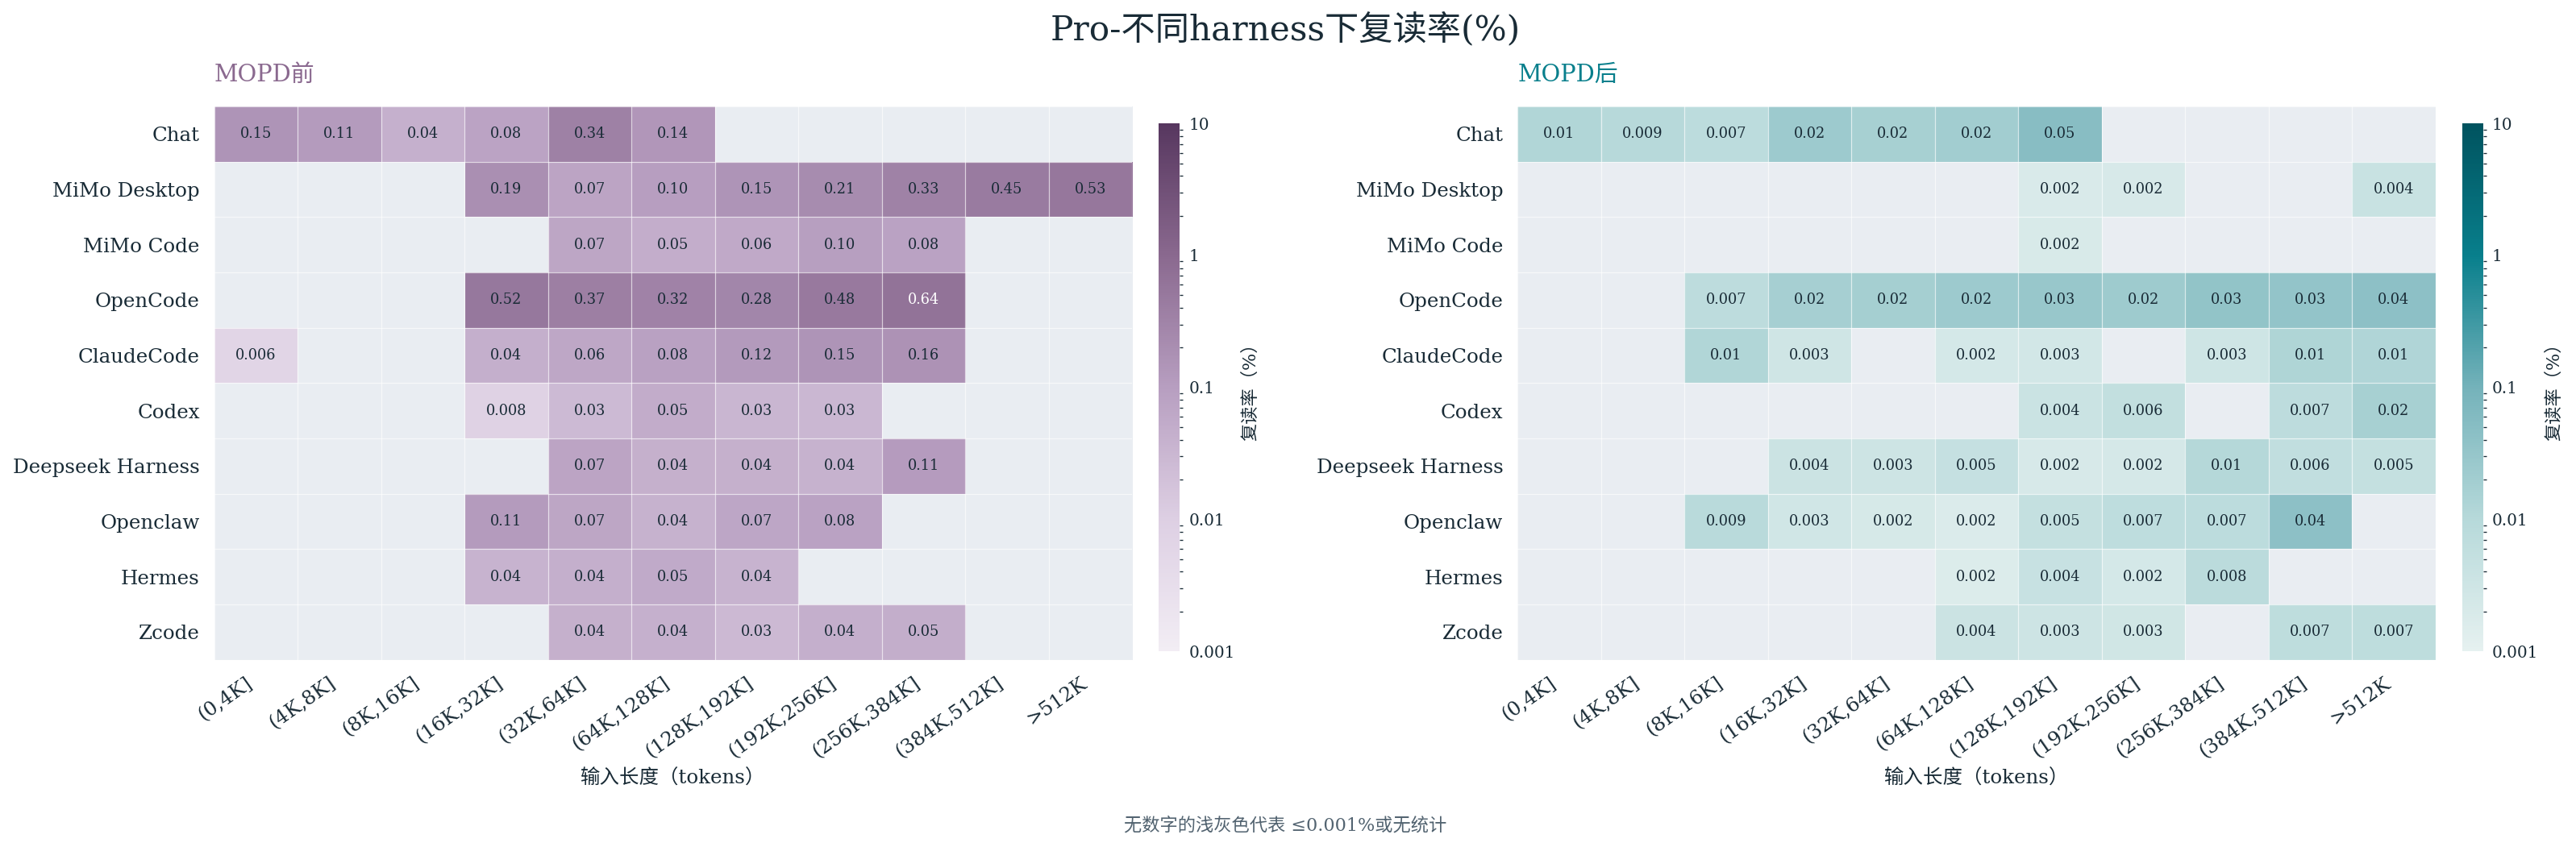
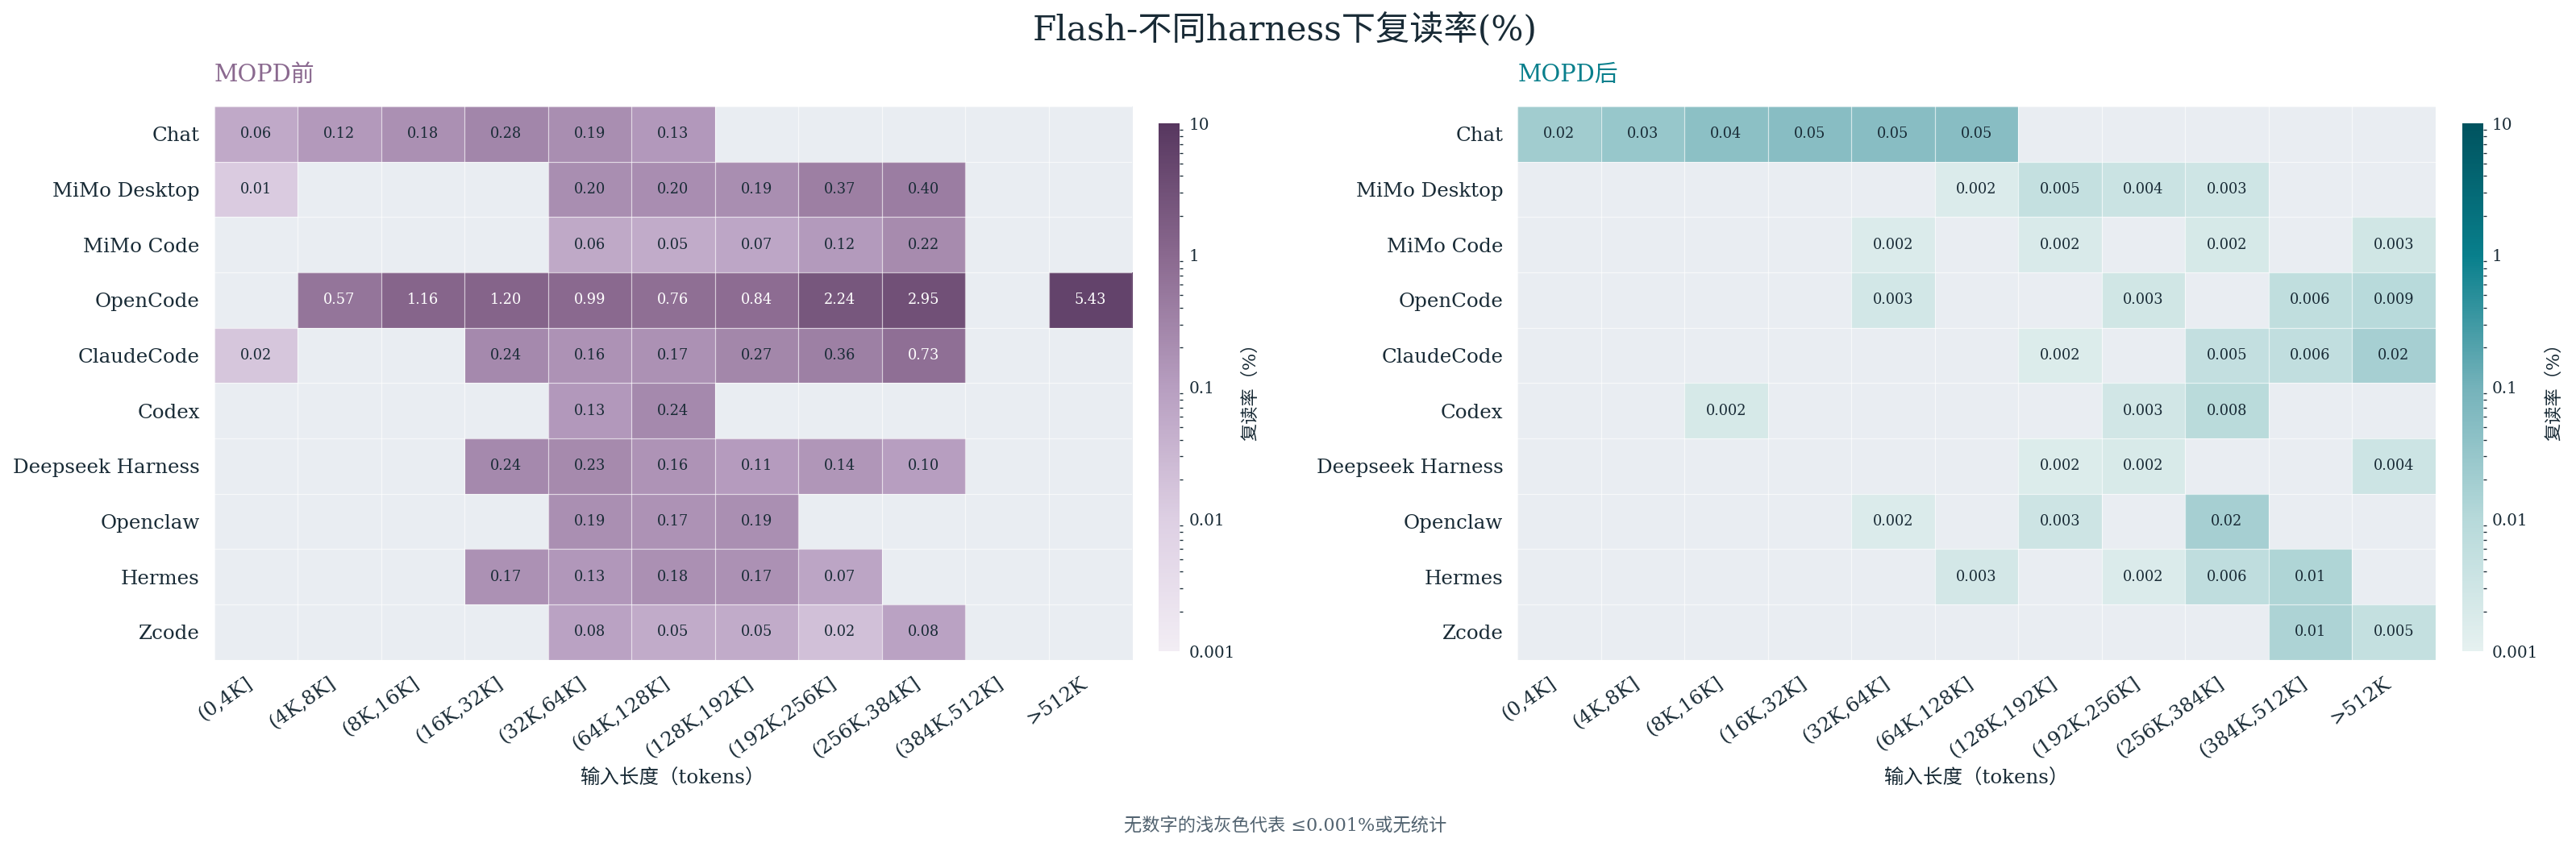
最终 MOPD 后的模型前后复读对比如下图:MiMo-V2.6-Pro 和 Flash 模型整体复读率在不同 context length 上大幅降低,且在不同 harness 上也同样降低,除了复读以外 benchmark 也持平(不降智)。最终全程训练成本约为 9 万美金,仅为上一个方案 MixRL 训练成本的 4%。
全新模型开源、Desktop 用量重置
我们已经把修复完工具调用复读的 MOPD 后的最新模型开源至 Hugging Face 的 MiMo-V2.6 collection(后缀为 MOPD)。
为了表达对广大用户的歉意,MiMo Desktop 当前时间窗口的剩余用量将会重置。
最新模型已于 9 月 25 日 06:00(UTC+8)后在 API 开放平台上线,调用名称保持 mimo-v2.6-pro、mimo-v2.6-flash 不变。
希望这篇博客能为分析和解决 RL 过程中产生的、看似微小且不易察觉,却会显著影响最终模型在广泛场景下实际体验的问题,提供一些启发。